Kafka 를 DB 처럼 읽기
로컬 인덱싱으로 Kafka 에 저장된 데이터를 유연하게 활용하기
Kafka 를 쓰면 으레 검색 스택이 따라붙는다. 그런데 찾으려는 메시지는 이미 토픽 안에 있다. 어떤 형식인지, 어떤 필드가 쓸 만한지는 데이터가 스스로 말해 주니, 토픽만 고르면 인덱스는 알아서 만들어진다.
이 글을 쓰게 된 이유
오랫동안 서비스에 Kafka 를 써왔다. 사용자 행동 추적, 이벤트 소싱 전파, 파이프라인 단계 간 작업 전달. 그리고 매번 같은 생태계가 그 주변에 세워졌다. 운영이나 장애 대응에서 메시지를 찾아야 하니 ELK, 데이터를 어딘가 영속 저장소로 보내야 하니 싱크 커넥터, 스트림을 집계하고 지켜봐야 하니 ksqlDB 나 Flink. 인프라가 늘고, 소프트웨어가 늘었다.
그러다 어느 날 문득 이런 생각이 스쳤다.
Kafka 는 컨슈머를 통해 메시지 스트림을 순차적으로 처리한다. 그러니 찾으려는 바늘의 파티션과 오프셋을 모르면 처음부터 Scan 하는 수밖에 없다. 그런데 그걸 안다면 — 다른 데이터베이스에서처럼 그 메시지에 바로 닿을 수 있지 않을까?
그 서비스에 ELK 는 필요하지 않았다. 추적 이벤트를 찾고 싶었을 뿐이고, 그건 이미 토픽 안에 있었다. 알아야 할 건 어디에 있느냐뿐이었다.
일반적인 Kafka 생태계 아키텍처
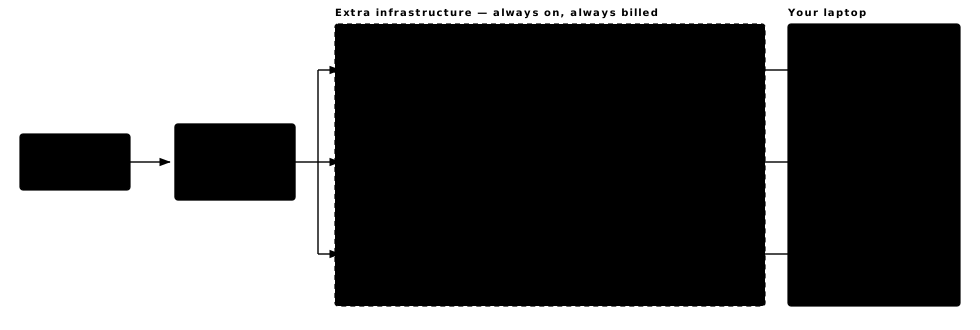
메시지를 검색하려면 Kafka Connect(또는 Logstash)로 Elasticsearch 에 넣고, 싱크 커넥터로 DB 에 보내고, 집계는 ksqlDB 나 Flink 로 한다. 하나하나가 떠 있어야 하고, 올려야 하고, 돈이 드는 서비스이며, 각각 다른 클라이언트로 들여다본다.
데이터 파이프라인을 구축하는 일은 데이터 엔지니어로서 즐겁고, 커리어에도 도움이 된다. 다만 운영 비용은 다른 문제다. 관리할 시스템이 늘어나는 만큼 구축과 유지보수에 비용이 든다.
회사 비용으로 나가는 것이라면 남의 예산이라 체감되지 않는다. 내 사업, 내 서비스라면 이야기가 달라진다.
이 서비스를 운영하는 데 진짜 이 파이프라인이 전부 필요한지를 생각해 봐야 한다.
로컬 인덱싱이 가능한 이유
Kafka 토픽의 데이터는 계속 덧붙는 방식으로 쌓이고, 파티션 안에서는 순서가 보장되며, 오프셋이라는 주소를 갖는다.
그래서 그 위의 인덱스는 (토픽, 파티션, 오프셋 범위) 의 순수 함수가 된다. 증분으로 만들어 갈 수 있고,
중단된 지점부터 이어갈 수 있으며, 그러는 동안 어디에도 진행 상태를 맞출 필요가 없다.
SQLite, DuckDB, RocksDB 등으로 로컬 디스크에 인덱스를 만들 수 있다. 각각의 비교와 선택 기준은 아래에서 따로 다룬다. 그리고 컨슈머 옆에 인덱스를 두는 일은 이 생태계에서 이미 익숙하다. Kafka Streams 가 상태를 RocksDB 에 두고, ksqlDB 도 그렇다. 달라지는 건 그 컨슈머가 어느 기계에서 도느냐뿐이다.
Kafka 만을 이용한 로컬 인덱싱 경량 아키텍처
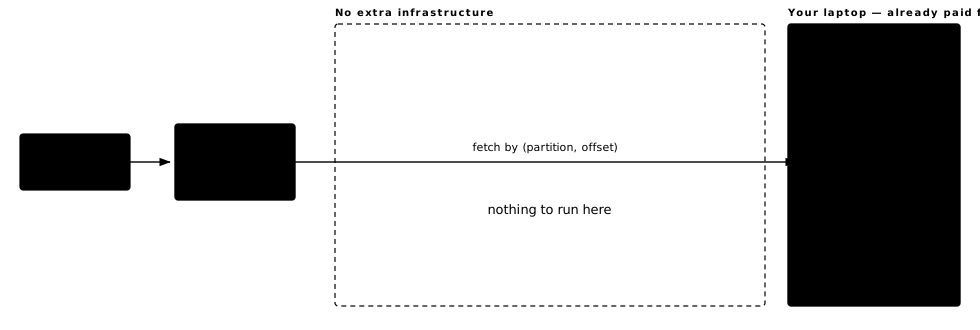
파티션과 오프셋을 명시해 가져오고, 인덱스를 로컬에 짓고, 로컬에서 검색한다. 같은 발상의 로컬 우선(local-first) 판본이다. 컨슈머 그룹에 참여하지 않고 오프셋도 커밋하지 않으니, 클러스터는 눈치채지 못한다.
메시지마다 키와 헤더와 값을 읽고, 그 토픽이 쓰는 형식으로 디코딩한 뒤, 결과를 훑는다. 발견한 모든 스칼라가 하나의 Term 이 된다. 그 값이 놓인 경로와, 거기 있던 값. 그렇게 찾을 일이 있는 필드라면 어절 단위로 쪼개 두기도 한다. 각 Term 은 그것이 나온 (파티션, 오프셋) 과 함께 기록된다.
그게 전부다. Term 에서 위치로 가는 정렬된 맵 하나, 그리고 결과 한 줄을 그리는 데 필요한 것만 담은 메시지당 레코드 하나. 그 밖에는 아무것도 보관하지 않는다. 메시지를 열 때 본문을 따로 가져와야 하는 이유가 그것이다.
Scan 과 Index Lookup
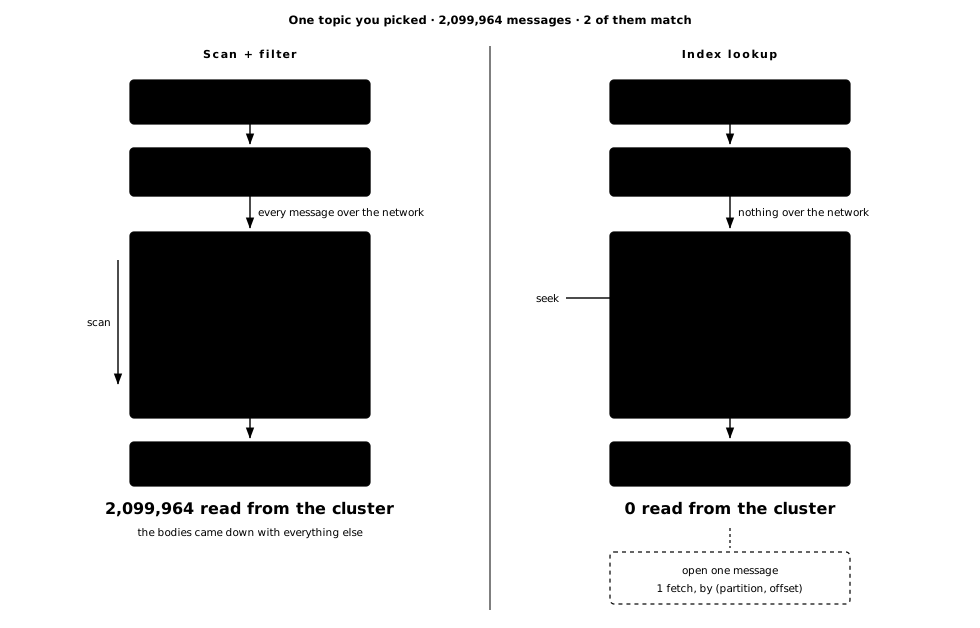
인덱스가 없으면 메시지를 찾는 길은 하나뿐이다. 토픽을 Scan 하고 클라이언트에서 거른다. 작업량은 답이 아니라 토픽 크기에 비례한다. 이백만 건 중 두 건을 찾는 데도 이백만 번의 네트워크 읽기가 들고, 쿼리를 다듬을 때마다 그만큼 또 든다.
인덱스는 그걸 뒤집는다. Term 이 정렬돼 저장되니, prefix 로 seek 하면 일치하는 블록에 곧장 내려앉고 그 양옆은 읽지 않는다. 각 엔트리가 (파티션, 오프셋) 과 한 줄을 그릴 만큼을 들고 있어서, 결과 목록 전체가 클러스터에 아무것도 묻지 않고 만들어진다. 쿼리를 몇 번 다듬든 읽기는 0 이다. 인덱싱은 앞에서 한 번의 읽기를 지불하고, 그 뒤로는 히트 수에 비례한다.
인덱싱 대상이 된 필드는 인덱스 안에 들어 있으므로, 목록을 조회하는 동안에는 클러스터에 아무것도 요청하지
않는다. 목록에서 한 건을 열어 상세를 볼 때에만 원본 메시지가 필요하고, 그때 (파티션, 오프셋)
으로 정확히 한 건을 가져온다. 컨슈머 그룹에 참여하지 않으면 커밋할 오프셋도 없으니, 리밸런스가 일어나지 않고
다른 컨슈머의 위치에도 영향을 주지 않는다.
검색을 위해 필요한 건 사전 인덱싱
위의 검색에는 한 가지 간과한 것이 있다. 검색을 하려면 먼저 인덱싱이 되어 있어야 하고, 인덱싱되기 전에는 아무것도 검색할 수 없다. 그리고 인덱싱을 하려면 토픽을 한 번 끝까지 읽어야 한다.
다만 그 읽기는 추가로 생긴 것이 아니다. Scan 도 어차피 모든 메시지를 끌어왔고, 그저 결과를 버렸을 뿐이다. 인덱싱은 같은 바이트를 옮기면서 알아낸 것을 남긴다. 더해지는 건 메시지당 작업뿐이다. 디코딩하고, Term 을 뽑고, 적어 둔다. 차이는 그게 전부다. 그리고 그마저 한 번만 지불한다. Scan 은 쿼리마다 다시 낸다.
데이터가 있으면 인덱싱은 자동화할 수 있다
파이프라인이 미리 선언하라고 요구하는 것 대부분은 이미 데이터 안에 있다. 메시지를 샘플링하면 바이트에서 직렬화 형식이 드러나고, 실제로 등장하는 것에서 인덱싱할 만한 필드가 드러난다. Schema Registry 를 쓰는 포맷도 데이터가 스스로 말해 준다 — 메시지가 스키마 ID 를 달고 다니니, Registry 주소만 지정해 주면 된다. 그렇게 몇 가지 선택만 하고 나면, 이후 인덱싱은 알아서 돌아간다.
인덱싱에 걸리는 시간
인덱싱 시간을 좌우하는 건 읽기가 아니라 메시지당 작업이다. 그 작업을 가볍게 다듬으면 백만 건도 배치로 걸어 둘 일이 아니라, 앉아서 기다리면 끝나는 일이 된다. 구현체에서 측정한 값은 부록에 있다.
토픽 전체를 읽는 건 한 번뿐이다
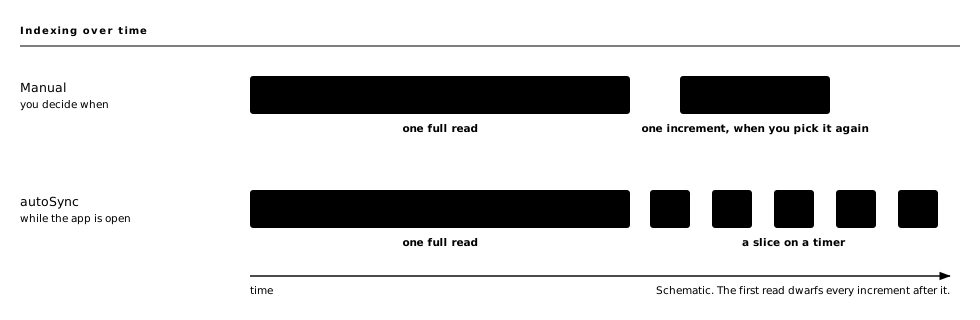
마지막으로 인덱싱한 오프셋이 파티션마다 기록되므로 같은 것을 두 번 읽지 않는다. 수동으로 두면 다음에 그 토픽을 고르거나 동기화를 누를 때 한 번에 따라잡고, autoSync 를 켜면 앱이 떠 있는 동안 조금씩 따라간다. 어느 쪽이든 전체 읽기는 한 번이고, 중단되면 처음이 아니라 멈춘 자리에서 이어간다.
내 데스크톱도, 당신의 데스크톱도 웹 브라우저를 돌리고 AI 에게 질문하는 데만 쓰기엔 너무 강력하고 값비싼 장비다.
디스크에 드는 비용
이쯤 되면 의문이 생기는 게 당연하다. Kafka 서버에 쌓인 그 많은 데이터의 인덱스를, 내 로컬 장비가 감당할 수 있을까?
인덱스를 효율적으로 관리한다면, 크기는 원본 메시지에 비해 크게 불어나지 않는다. 비용이 필드당, 건당 떨어지니 한 바이트도 읽기 전에 판단할 수 있다. 수치는 부록에 있다.
그러니 문제는 클러스터가 얼마나 크냐가 아니라, 그중 얼마를 담느냐다. 서버에 있는 걸 다 넣을 이유가 없다. 검색할 토픽만, 그 안에서 실제로 쓰는 필드만, 볼 만큼의 건수만 남기면 노트북 한 대로 충분하다.
전부 인덱싱하지 않기
토픽은 인덱싱할 때 고르고, 건수와 필드는 나중에도 정리 정책으로 줄일 수 있다.
| 전략 | 줄이는 축 | 설정 |
|---|---|---|
| 실제로 검색할 토픽만 인덱싱 | 토픽 통째 | — |
| 파티션당 최근 N 건만 유지 | 메시지 | CountBased |
| 검색하는 필드만 유지 | 필드 | FieldBased |
인덱스 크기가 부담되기 시작하면 모든 필드를 넣을 필요는 없다. Kafka 페이로드에는 온갖 것이 담기고, 검색할 일이 없는 필드 — 인코딩된 것, 긴 문장 — 는 빼도 된다. 비용이 필드당 떨어지니 뺀 만큼 비례해 줄어든다. 어느 JSON 토픽을 실제로 검색하는 필드만 남겼더니 인덱스가 5분의 1쯤 줄었다.
그래도 디스크가 찰 때
위의 전략들은 미리 내리는 선택이다. 그와 별개로, 그 선택이 무엇이든 지켜지는 천장이 필요하다. 인덱스 전체에 용량 예산을 걸어 두고 주기적으로 확인해, 넘어서면 묻지 않고 공간을 회수하는 것이다. 말하자면 인덱스의 GC 다. 언제 정리할지를 사람이 기억하고 있을 필요가 없다.
무엇을 회수할지는 토픽별 정책이 정하고, 각각은 같은 질문에 대한 서로 다른 답이다. 무엇을 모르게 되는 것이 가장 싼가? 아래는 지금 존재하는 것들이다.
| 정책 | 포기하는 것 |
|---|---|
| CountBased | 오래된 메시지가 검색되지 않게 됨 |
| FieldBased | 그 필드들이 검색되지 않게 됨 |
| DropIndex | 토픽이 미인덱싱 상태로 돌아감 |
| … | 목록은 열려 있다. N 건당 한 건만 표본으로 남기는 방식이 다음 후보이고, 약간의 상세함을 많은 공간과 바꾸는 것이라면 여기 속한다 |
버려진 인덱스는 잃어버린 데이터가 아니다. 메시지는 여전히 Kafka 에 있고, 그 토픽을 다시 고르면 인덱스는 다시 만들어진다. 내가 소유한 데이터베이스에서 테이블을 지우는 것과 여기서 공간을 회수하는 것의 차이가 그것이고, 정리를 자동으로 돌려도 되는 이유이기도 하다.
인덱스를 어디에 둘 것인가
여기까지 오면 인덱스가 무엇을 요구하는지 드러난다. 토픽을 받아들이는 동안의 길고 지속적인 쓰기, 검색할 때마다의 정렬된 prefix seek, 그리고 정책이 잘라낼 때마다 통째로 버려지는 조각들.
| SQLite B-tree, FTS5 | DuckDB columnar | RocksDB LSM tree | |
|---|---|---|---|
| 잘하는 것 | 랭킹 있는 전문 검색, trigram 으로 부분 문자열 | 대용량 위의 SQL 과 집계 | 지속적 쓰기, 싼 대량 삭제 |
| 대가 | 인덱스가 빠르게 커지고, 잘라낸 공간은 따로 회수해야 함 | 인덱스는 = 과 IN 까지. prefix 조회는 스캔이고, 잘라내면 데이터를 다시 씀 |
매칭은 직접 만들어야 함. n-gram 포함 |
| 고를 때 | 데이터가 넉넉히 들어갈 때 | 답이 집계값일 때 | 데이터가 계속 커질 때 |
이 글이 근거로 삼은 구현체에는 RocksDB 를 골랐다. 이름은 마지막에 나온다. 앞선 둘은 인덱싱에 필요한 많은 부분을 자동으로 해 주어 더 편리한 점도 있다. 하지만 ksqlDB 가 RocksDB 를 택한 데는 이유가 있고, 여기서도 같은 이유다. LSM 트리는 Kafka 데이터가 쌓이는 방식과 맞고, 더미가 계속 커져도 성능을 유지한다.
그 대신 키 설계와 어절 분리, 나머지 매칭까지 전부 직접 만들어야 한다. 양날의 검이다. 완성된 검색 기능을 받지는 못하지만, 쿼리 플래너에 해당하는 층까지 내 코드가 되니 어떻게 읽을지를 데이터에 맞춰 직접 정하고 튜닝할 수 있다.
키가 정렬돼 있으면 두 가지를 바로 할 수 있다. 값이 정확히 맞는 자리로 뛰거나, 어떤 문자열로
시작하는 구간으로 뛰거나. 그 너머는 공짜가 아니다. 문장 안의 단어를 맞히려면 쓰기 전에 어절을 쪼개야 하고, 단어의 일부를 맞히려면 n-gram 인덱스가 필요하다. 크기를 따로 차지하는 두 번째 인덱스다.
결국 %oo% 같은 부분 문자열까지 지원하려고 인덱스를 불리느냐, 포기하고 가볍게 가느냐의
선택이다.
그리고 그 키를 어떻게 설계하느냐가 구현체의 핵심이 된다.
로컬 인덱스의 한계
로컬 인덱스가 언제나 답이 되지는 않는다. 파이프라인만이 할 수 있는 일이 분명히 있다. 아래는 둘을 나란히 놓은 표이고, 한계는 아래쪽에 모여 있다.
| 파이프라인 | 로컬 인덱스 | |
|---|---|---|
| 첫 검색 전에 | Connect·Elasticsearch·Kibana 설치와 배선, 그리고 매핑 작성 | 앱 설치, 그리고 토픽 한 번 읽기 |
| 운영 | 상시 구동. 버전·샤드·디스크 | 없음 |
| 고정비 | 인스턴스 비용, 매달 | 없음 — 이미 가진 장비 |
| 데이터가 가는 곳 | 클러스터 밖으로 복제됨 | 내 디스크에 머묾 |
| 클러스터 부하 | 전부를 계속 복제 | 인덱싱 한 번, 그 뒤엔 여는 것만 |
| 매칭 | 애널라이저·와일드카드·단어 일부 | 값·prefix·온전한 단어 |
| 규모 한계 | 노드를 늘려 수평 확장 | 한 대가 담는 만큼. 늘려도 여전히 한 대 |
| 팀 공유 | 모두가 같은 화면을 봄 | 안 됨 — 각자의 디스크 |
| 보존 | 영구 보관 가능 | Kafka 보존 기간 + 로컬 정리 |
| 지속적 활용 | 빅데이터 시스템·DB 같은 영속화 레이어로 계속 적재 | 사람이 열어 볼 때만 |
인덱스가 한 대에 담기지 않거나, 팀이 하나의 화면을 공유해야 하거나, 데이터가 Kafka 의 보존 기간보다 오래 살아야 한다면 파이프라인이 맞는 답이다. 그중 가장 큰 것은 마지막 줄이다. 그 데이터가 결국 어딘가에 쌓여야 한다면 — 빅데이터 시스템이든 DB 든, 거기서 읽어 가는 다른 시스템이 있다면 — 사람이 열 때만 도는 인덱스로는 대신할 수 없다. 로컬 인덱스는 이 넷에 걸리지 않는 경우에만 쓸 수 있다.
요약
- 데이터가 있으면 인덱싱은 자동화할 수 있다. 형식도 필드도 데이터에서 드러나므로, 몇 가지만 고르면 매핑도 스키마 등록도 커넥터 설정도 필요하지 않다.
- 인덱스는 읽은 것의 순수 함수다. 토픽이 오프셋으로 주소를 갖기 때문이다. 그래서 전체 읽기는 한 번뿐이고 — Scan 도 어차피 했을 그 읽기다 — 그 뒤로는 증분만, 중단되면 멈춘 자리에서 이어간다.
- 인덱스는 원본 메시지에 비해 크게 불어나지 않는다. 그리고 빼는 필드만큼, 담는 건수만큼 줄어든다.
- 검색은 로컬 인덱스 안에서만 이루어져 클러스터에 부하를 주지 않는다. 메시지를 열 때만 파티션과 오프셋을 명시해 Kafka 로 돌아간다.
- 커버하지 못하는 경우: 인덱스가 한 대에 담기지 않을 때, 팀이 하나의 화면을 공유해야 할 때, 데이터가 Kafka 보존 기간보다 오래 살아야 할 때, 그리고 영속화 레이어가 필요할 때.
맺으며
Kafka 는 훌륭한 데이터 저장소다. scalable 하고, reliable 하고, responsive 하다. 수많은 서비스가 Kafka 를 도입하는 데는 그럴 만한 이유가 있다.
하지만 대부분 데이터 파이프라인 구축을 동반한다. Kafka 를 사용하면 보통 그렇게 활용하기 때문이다.
데이터는 이미 Kafka 안에 잘 보관되어 있다. 인덱스만 자동으로 만들어 줄 수 있다면 토픽 데이터는 Database 처럼 활용할 수 있다.
서비스에 Kafka 를 도입할 때, 로컬 인덱스를 활용한 또 다른 모습도 구상해 보면 좋겠다.
위의 아키텍처는 Kaflow Search 로 구현되어 있다. 설치형 local-first 데스크톱 애플리케이션이다.
macOS 11+ · Windows 10+ · 무료, 계정 필요 없음 아직 서명되지 않아 첫 실행 때 흔한 우회 절차가 필요하다. 붙일 클러스터가 없다면 데모 빌드가 있다.
부록: Kaflow Search 로 측정한 값
32 GB M4 에 설치한 Kaflow Search 에서, RocksDB 기본 압축으로 측정한 값이다. 장비나 저장소가 다르면 숫자도 달라지니 절대값은 참고만 하면 된다.
인덱싱 속도
| 토픽 | 필드 | 속도 | 10만 건 | 100만 건 |
|---|---|---|---|---|
| chat-messages | 19 | 초당 약 10,000 | 약 10초 | 약 100초 |
필드는 아래와 같은 기준으로 셌다. 선언된 15 개가 배열 필드까지 펼쳐지며 건당 약 19 개가 된다. 병목은 네트워크가 아니라 노트북이었다. 더 빠른 기계면 더, 원격 클러스터면 덜 나온다.
디스크
네 개 토픽, 각 백만 건, 전 필드 인덱싱. 원본 은 키와 값과 헤더를 압축 전 순수 JSON 으로 측정한 크기이고, 로컬 저장 은 RocksDB 가 실제로 들고 있는 양으로 메시지와 그 위의 인덱스를 합친 것이다. 건당 바이트 수가 곧 100만 건일 때의 메가바이트 수다.
모든 필드를 인덱싱하면 원본의 1.1~1.2 배다. 여기서 원본은 Kafka 클러스터가 쓰는 디스크가 아니라 데이터 자체의 크기다. 어절을 쪼개거나 n-gram 을 쌓으면 검색은 정교해지지만 인덱스도 그만큼 커진다. zstd 를 쓰면 그보다 줄어들 수 있는데, 얼마나 줄지는 데이터에 따라 다르다.
| 토픽 | 필드 | 원본 / 건 | 로컬 저장 / 건 | zstd 적용 | 10만 건 | 100만 건 |
|---|---|---|---|---|---|---|
| inventory-events | 21 | 515 B | 586 B1.14× | 418 B0.81× | 64 MB | 586 MB |
| notification-events | 22 | 593 B | 673 B1.14× | 516 B0.87× | 71 MB | 673 MB |
| payments-events | 26 | 636 B | 768 B1.21× | 483 B0.76× | 79 MB | 768 MB |
| crawled-market-signals | 31 | 840 B | 927 B1.10× | 656 B0.78× | 90 MB | 927 MB |
마지막 두 열은 규모가 커져도 모양이 유지된다는 것도 말해 준다. 건수가 열 배가 돼도 건당 크기는 0.92~1.03 배에 머물렀다. 작게 측정해 보면 큰 토픽을 예측할 수 있다는 뜻이다. 이론상 100 GB 로컬 디스크면 1억 건 이상도 담을 수 있다. 다만 로컬이라는 특성상 그렇게 거대한 데이터를 들고 있는 것은 권하지 않는다.
마지막 두 열은 기본 압축인 snappy 기준이다. zstd 는 더 줄일 수 있지만 쓰기가 느려질 수 있어, 둘은 장단점이 갈린다.